I fondamenti del collegamento PCIe: corsie, training e velocità reali
Corsie, link training LTSSM, interfaccia PIPE e generazioni da 2,5 a 64 GT/s: la traccia per leggere una specifica PCI Express e arrivare alla banda utile.
Una specifica tecnica si legge come un bilancio: prima le definizioni, poi le unità, infine i numeri. Il collegamento PCI Express, il bus che collega schede e dischi alla scheda madre, offre un caso di studio ordinato: corsie come unità di misura, una macchina a stati detta LTSSM che avvia il collegamento, un’interfaccia standard chiamata PIPE e una scala di velocità che corre da 2,5 a 64 gigatransfer al secondo. Questa guida mette in fila le parole che la documentazione dà per scontate e mostra come dalla velocità nominale si arriva alla banda passante utile.
Leggere una specifica come si legge un bilancio
Il metodo è identico a quello usato per un prospetto finanziario: ogni grandezza va ricondotta alla sua definizione prima di essere confrontata. Una velocità dichiarata senza l’unità e la generazione di riferimento è un numero sospeso, esattamente come un rendimento senza costi e orizzonte. La specifica PCI Express è pubblica nella sua struttura e il vocabolario che usa, corsia, link, training, è rigoroso: basta una pagina di glossario per leggere il resto.
Chi vuole il percorso completo trova una scrivania di lettura dedicata in Root Complex, una pubblicazione in inglese che legge il collegamento PCI Express dalle specifiche e dalle documentazioni pubbliche: corsie, sequenza di training, connettori e test di conformità, con ogni cifra accompagnata dal documento che la origina e dalla data in cui è stata riletta.
La corsia e il link: l’unità che conta
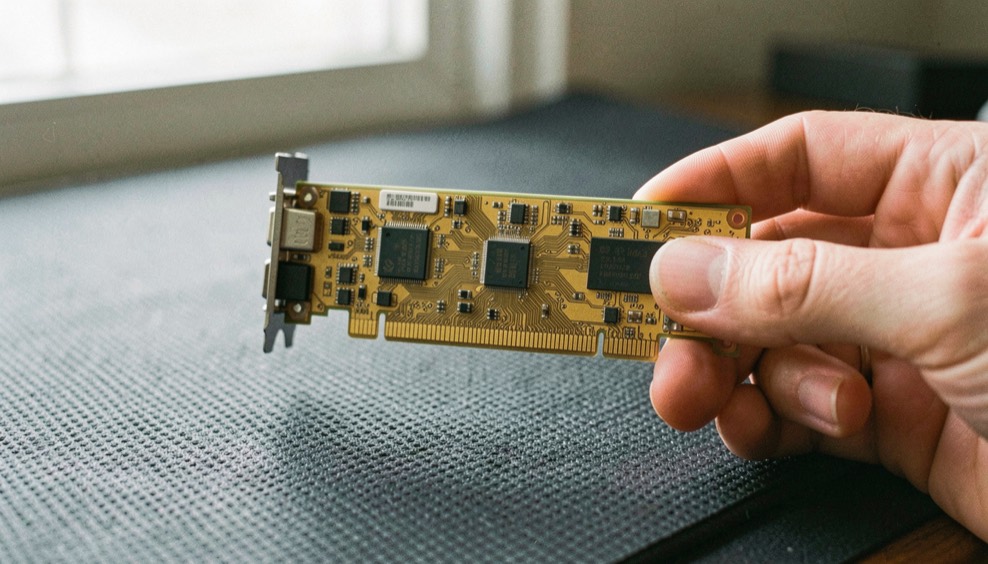
La corsia, lane in inglese, è la cella elementare: due coppie differenziali di conduttori, una per ogni direzione, così il collegamento trasmette e riceve nello stesso istante. Un link è un fascio di corsie: x1, x4, x8 o x16 indicano quante corsie lavorano in parallelo, e la lunghezza del connettore sul bordo della scheda madre corrisponde alla larghezza massima supportata. La velocità pubblicizzata è sempre per corsia: il totale si ottiene moltiplicando.
Da questa aritmetica nasce la prima regola di lettura: sedici corsie a una generazione datata possono valere meno di quattro corsie a una generazione recente. Quando una scheda dichiara la propria larghezza e la propria generazione, il prodotto dei due numeri, non uno dei due da solo, descrive la capacità effettiva del collegamento.
Una seconda regola riguarda la direzione: poiché ogni corsia porta le due direzioni in coppie separate, la banda dichiarata vale in ciascun verso. Leggere «32 GT/s» senza chiedere su quante corsie e in quale direzione è come leggere un patrimonio senza distinguere attività e passività: il numero esiste, ma non descrive ancora la situazione.
Il training LTSSM e l’interfaccia PIPE
All’accensione le due estremità del link non iniziano a scambiare dati: eseguono una sequenza fissa di stati, la LTSSM, Link Training and Status State Machine. In ordine: rilevare la controparte, concordare il numero di corsie, concordare la velocità comune, calibrare il segnale. Solo alla fine il link entra nello stato operativo chiamato L0. Un collegamento che resta a una velocità inferiore a quella attesa è quasi sempre il risultato leggibile di un training che si è fermato a un compromesso.
Sotto il protocollo lavora PIPE, PHY Interface for PCI Express: la specifica che definisce il confine tra la parte logica del controllore e il circuito fisico che pilota i conduttori. È il motivo per cui un controllore di un fornitore e un circuito fisico di un altro possono essere progettati separatamente e funzionare insieme: un’interfaccia pubblica, non un accordo privato.
Le due macchine si osservano a livelli diversi: la LTSSM è il dialogo tra le due estremità del link, PIPE è il patto interno tra logica e circuito dentro ciascun dispositivo. Confonderli produce diagnosi sbagliate: una larghezza minore del previsto viene dal training, una scheda che non comunica affatto può nascondere un problema di interfaccia. Tenere separati i due livelli è ciò che permette di leggere un sintomo invece di subirlo.
Le generazioni: da 2,5 a 64 GT/s
Ogni generazione della specifica raddoppia il trasferimento per corsia rispetto alla precedente, ma la storia non è solo il numero: è anche il codice con cui i bit viaggiano. La velocità si esprime in gigatransfer al secondo, il numero di simboli trasmessi; quanti di quei simboli diventano byte utili dipende dall’encoding, che è cambiato due volte.
- Gen1: 2,5 GT/s, encoding 8b/10b, circa 250 MB/s utili per corsia.
- Gen2: 5 GT/s, stesso encoding, raddoppio diretto.
- Gen3: 8 GT/s, encoding 128b/130b, overhead quasi dimezzato.
- Gen4 e Gen5: 16 e 32 GT/s, stesso encoding della Gen3.
- Gen6: 64 GT/s, segnalazione PAM4 e pacchetti a formato fisso FLIT.
Dalla velocità nominale alla banda passante utile
La tabella delle velocità è la pagina che chiarisce ogni messaggio commerciale: una scheda pensata per una generazione recente collocata in uno slot datato cede metà della capacità senza che nessuna etichetta lo dichiari. Leggere la generazione dello slot prima di quella della scheda è la stessa disciplina di leggere i costi prima del rendimento.
Il conto finale è semplice da impostare: gigatransfer per corsia, per il numero di corsie, per l’efficienza dell’encoding, meno l’overhead dei pacchetti di protocollo. La prima generazione perdeva un quinto della capacità nel solo encoding 8b/10b; dalla terza in poi la perdita è scesa a circa l’uno e mezzo per cento. Il numero stampato sulla scheda è il punto di partenza del calcolo, non la sua conclusione.
Un esempio didattico con le ipotesi dichiarate: sedici corsie alla terza generazione, con encoding 128b/130b, portano circa centoventotto gigabit al secondo di simboli per direzione; tradotti in byte e scontato l’overhead restano poco meno di sedici gigabyte al secondo teorici. Cambiare una sola ipotesi, la generazione o la larghezza, cambia il risultato: per questo la scheda di lettura tiene le ipotesi in cima e il risultato in fondo.
Il limite di questa lettura va dichiarato: la banda utile misurata dipende anche dal traffico reale, dalle dimensioni dei pacchetti e dal controller. Come in un’analisi di bilancio, il quadro ordinato non elimina l’incertezza: la restringe a ciò che vale la pena misurare.
Fonti primarie
Documenti consultati
Per proseguire
Altri dossier
Leggere un ciclo di mercato senza predizioni
Un metodo per osservare trend, volatilità e partecipazione del mercato senza confondere una sequenza di dati con una certezza sul futuro.
Leggi l’articolo
Gli indicatori macro davvero utili
Inflazione, tassi, lavoro, produzione e credito in un cruscotto essenziale che distingue il dato dalla sua interpretazione.
Leggi l’articolo
Trovare i costi dei prodotti finanziari
Una checklist italiana per distinguere costi di prodotto, servizio e transazione prima di confrontare due proposte finanziarie.
Leggi l’articolo